背景說明
資料中心:reclaim 是常態運轉的機制
- Memory overcommit 是商業模式的一部分。實體記憶體是伺服器最貴的元件之一,閒置的 RAM 就是燒掉的錢,配置給虛擬機器的記憶體總量超過實體容量,靠 reclaim 與 swap(或 zram/zswap、far memory)對沖。
- 單機上千個 process 是常態:fork-based server(Apache prefork、PostgreSQL、早期 CGI)、KVM、container、每個租戶一組 process tree。cgroup 對每個租戶設 memory.max,memcg reclaim 隨時在跑。
- Proactive reclaim:與其等到 direct reclaim 卡住,不如平時就持續把 Cold page 擠出去(memory.reclaim、kswapd/MGLRU 式的背景老化)。
那麼問題來了,作業系統到底要怎麼找到這些 Page?或者更精確地說,在回收 Page 之前系統需要知道:
- 這個 Page 最近有沒有被使用?
- 現在還有哪些行程在用它?
正向走訪 Page
Task 存取一個虛擬位址時由 MMU 查詢 TLB,TLB miss 時由硬體的 page walker 自行走訪 page table 補上 TLB entry。只有當 walker 找不到 Entry 或權限違規時,CPU 才觸發 #PF 例外(x86 IDT vector 14,CR2 存出錯 VA),進入核心的 page fault 路徑。若該頁需要操作儲存裝置(例如 swap-in 或首次讀入 File-back Page/Folio),則屬於 Major fault,否則仍為 Minor fault。
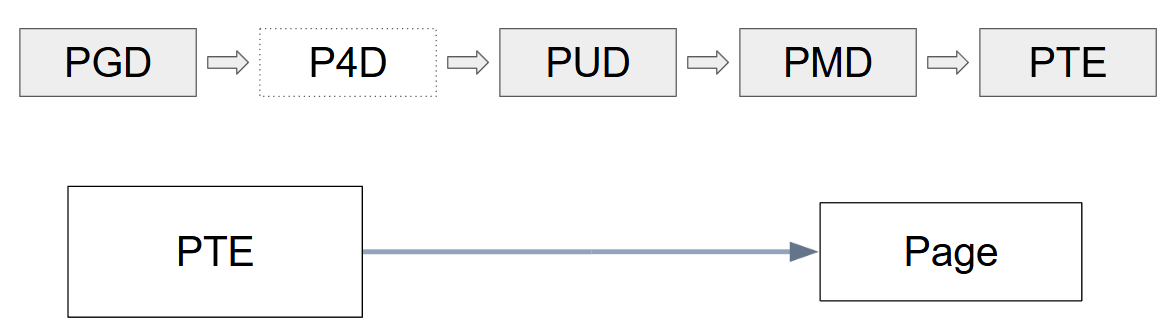
核心端由 __handle_mm_fault() 進入,完成 PGD -> P4D -> PUD -> PMD -> PTE 共五層(未啟用五層分頁時 P4D 折疊,實際為四層)的逐層走訪。每層若 entry 不存在則視情況以 pud_alloc()、pmd_alloc() 等配置下一層 page table 並建立對應關係。
RMAP (反向走訪)
當可用記憶體低於 low watermark(WMARK_LOW)時 kswapd 被喚醒在背景進行非同步 Page reclaim,低於 WMARK_MIN 則觸發 Direct reclaim 同步執行。
Page reclaim 時 Linux 核心從 LRU List 上挑出候選 Page/Folio 回收與檢查這個 Page/Folio 熱度,確認是 Cold Page 後再檢查該 Page/Folio 被哪些虛擬記憶體(Task 所屬 mm_struct 指到的 pte_t)對應以及 Page/Folio 熱度(根據 Access bit),並視情況清除 PTE mapping。才能安全地把 Anon Page/Folio 寫入 swap 或 直接丟棄/Writeback File-back Page/Folio。
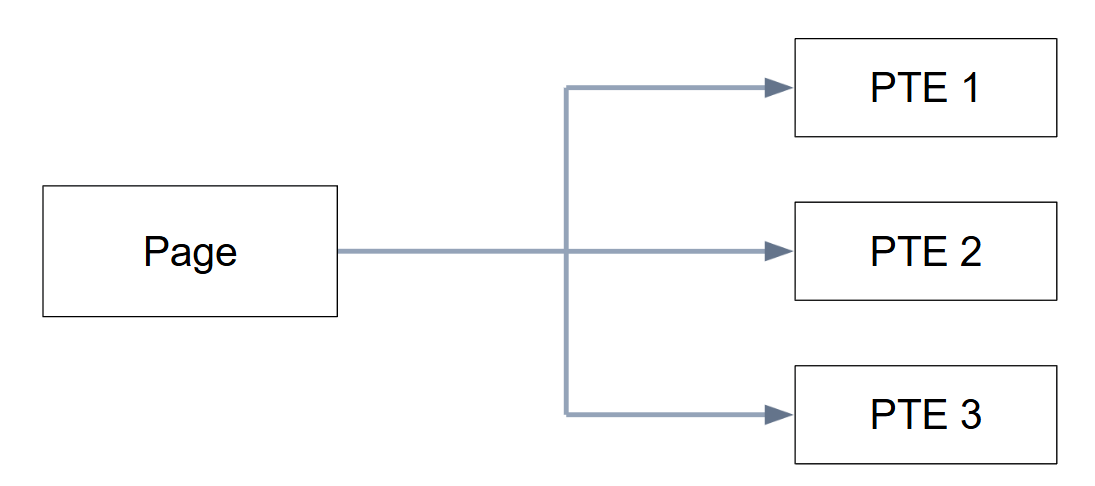
沒有 RMAP metadata 的情況如何實現 RMAP?
那麼問題來了,我們要怎麼知道這塊 Page 被哪些虛擬記憶體所對應?若沒有任何資料結構輔助,則只能藉由掃描所有 Task 的 mapping 來找到目標 Page/Folio 對應的 PTE 存取狀態 ( Accessed Bit ),並在沒有任何 Task 對應的時候將 Page/Folio 回收到 SWAP。
而這帶來以下兩個問題:
- 成本與「系統上 PTE 總數」成正比,而不是與「需要回收的 Page 數」成正比。掃描大量映射著熱頁的頁表,是純粹的浪費。
- 被多個 process 共享的 Page 必須等到所有映射都在各自的掃描中被拆掉,才真正可回收。核心無法主動選定一個 Page 一次拆光它的映射,Accessed bit(Page 熱度)也散落在各個 Page table 中,無法針對單一 Page 彙整
以 Linux v2.4 之前的 reclaim 為例。它會由 swap_out() 從 init_mm 開始走訪,線性掃描其 Page table,看哪個 PTE 指向的 Page 可以拆掉映射。
Linux 的 RMAP 發展
- per-page (pte_chain): 2.5.27 ~ 2.6.6
- per-object (anon_vma): 2.6.7 ~ 2.6.33
- anon_vma_chain: 2.6.34 ~
從 anon_vma_chain 之後 RMAP 的結構就大致固定,只在部分實作與架構修改
per-page RMAP(pte_chain)
既然問題是「無法從 Page 找到所有 mapping 到該 Page 的 PTE」,那麼最簡單的方式就是直接在 Page 紀錄所有對應到的 PTE。有鑑於此,Rik van Riel 在 2.4.17-rmap-12e 時提出 RMAP,具體實作是在 struct page 這個資料結構上加入 pte_chain 欄位,其指向一條串起所有對應 PTE 位址的鏈結串列,這樣在 Reclaim 時只需要走訪這個鍊結串列並檢查 Accessed Bit。不用像之前走訪整個系統的所有 PTE 了,該 Patch 於 2.5.27 合併至主線。
#define NRPTE ((L1_CACHE_BYTES - sizeof(unsigned long))/sizeof(pte_addr_t))
// NRPTE = 7 when L1_CACHE_BYTES = 64// 3 when L1_CACHE_BYTES = 32
struct page { ... struct pte_chain *pte_chain; /* 指向所有映射此頁的 PTE */ ...};
struct pte_chain { unsigned long next_and_idx; pte_addr_t ptes[NRPTE];} ____cacheline_aligned;
pte_chain_encode(pte_chain, idx): return (unsigned long)pte_chain | idx;pte_chain_next(pc): return (struct pte_chain *)(pc->next_and_idx & ~NRPTE);pte_chain_idx(pc): return pc->next_and_idx & NRPTE;
page_add_rmap(page, ptep);page_remove_rmap(page, ptep);pte_chain 時期根本沒有 VMA 層級的插入與刪除。記錄單位是 PTE。
page_add_rmap(page, ptep); /* 缺頁處理時,把 pte 位址串上該 page */page_remove_rmap(page, ptep); /* unmap 時,線性掃描找到並移除 */fork():copy_page_range() 逐一走訪 pte,對每個已映射的 page 呼叫一次 page_add_rmap()。成本 O(頁面數),記憶體也是 O(映射數)。
munmap() / exit():zap_pte_range() 逐一 page_remove_rmap(),且刪除時需線性掃描 pte_chain 找到匹配項。
從 per-page 到 per-object 的 RMAP(anon_vma)
然而這項設計還是有問題,隨著共用 task 數增長,pte_chain 鏈結串列的長度也會增長,整個走訪的時間複雜度為 O(N)\text{,N 為 pte_chain 鍊結串列的長度}。
除此之外,pte_chain 帶來的記憶體開銷與系統本身的記憶體大小成正比,由於 pte_chain 至少需要額外 12 Bytes 的空間,即使只是在配備 128MB RAM 的 32-bit 系統中,pte_chain 帶來的記憶體開銷也需要 400KB。
考慮 pte_chain 本身的記憶體開銷問題,社群接受度並不高,因此社群開始討論如何去除 pte_chain 記憶體開銷。對於 File-back page 可以從 address->i_mmap 反查使用的 PTE,然而 Anon page 沒有類似的資料結構,因此 anon_vma 出現了。
在 2.6.7 ,RMAP 從原本的由 Page 擴充 pte_chain 串連改為讓 Anon/File-back page 共用 mapping 欄位,其中 File-back page 放 address_space,Anon page 放 anon_vma,並透過該指標的 LSB 判斷具體存放內容。
struct page { ... struct address_space *mapping; ...};anon_vma 藉由鏈結串列將屬於自身的 vma 串連起來,多個 Page 會對應到同一個 anon_vma。unmap 時藉由 page->index 算出 page offset 後藉由走訪 anon_vma 中的每個 vma,將 page offset 與該 vma 的起始位址相加來判斷這個 vma 與 page 是否關聯,並找出其對應的 PTE。
struct anon_vma { spinlock_t lock; struct list_head head; /* 串接 vma->anon_vma_node */};- 插入(Page fault):anon_vma_prepare(vma)。先透過 find_mergeable_anon_vma() 嘗試沿用相鄰可合併 VMA 的 anon_vma,找不到才配置新的,最後 list_add(&vma->anon_vma_node, &anon_vma->head)。
- 插入(fork):anon_vma_link(vma)。子行程直接沿用親代行程的 anon_vma,把自己的節點掛上同一條串列。
- 插入(vma 分裂):split_vma() 產生的新 VMA 共用同一個 anon_vma,同樣 anon_vma_link()。
- 刪除:anon_vma_unlink(vma),list_del() 後檢查串列是否已空,空了就釋放 anon_vma。
從 anon_vma 到 anon_vma_chain
2004 年引入的 anon_vma 解決了 pte_chain 的記憶體開銷,但它對 fork() 的處理過於粗糙:子行程的 VMA 直接掛進親代行程的 anon_vma,整個行程家族共用同一個 anon_vma。
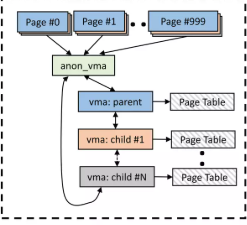
Andrew morton 曾經在 2003 年 object rmap 被合併前針對該機制提出疑惑,object rmap 設計是走訪整個物件 (如 anon_vma 或 address_space) 上關聯的所有 vma,這時一定會走訪到完全無關於要回收 Page 的 vma,並且花費大量時間在走訪動作。反而是 pte_chain 只需要針對 page 相關的 pte 走訪即可。同時他還用一個極端案例說明問題:對於使用相同檔案的 1000 個 Task,當每個 Task 在相同檔案使用 1000 個 vma 時,總共會有 100 萬個 vma,並且在 unmap 時無論如何都需要走訪這 100 萬個 vma。雖然他只提到 File-back page,然而既然說是設計本身問題,代表 Anon page 也有可能出現相同問題。
Andrew 當時本人傾向認為這只是「理論上可能發生」,問題不大,畢竟 2.4 的 virtual scan 設計也有相同問題但沒人遇到。然而 7 年後,Andrew morton 擔心的事確實發生了。
Without the anon_vma changes, when AIM7 hits around 9.7k users (on a test box with 16GB RAM and not quite enough IO), the system ends up running >99% in system time, with every CPU on the same anon_vma lock in the pageout code.
Rik van Riel 發現 AIM7 Benchmark 當使用者數量到 9.7k 時卡死,並且大部分時間都在搶佔 anon_vma 的鎖上面,這也印證了上面提到的需要花費大量時間在走訪的問題。
有鑑於此,Rik van Riel 針對上述問題提出修改的 PATCH,具體想法為針對各個行程建立一個 anon_vma 並使用 anon_vma_chain 資料結構串連 anon_vma 與 vma,再使用 same_vma 與 same_anon_vma 將映射到相同的「vma 或 anon_vma」的 avc 串連起來,行成多對多的關聯。
應用此 PATCH 後 AIM7 到 29.7k 個使用者才開始卡死,並且瓶頸變為 I/O 等待。
struct anon_vma_chain { struct vm_area_struct *vma; struct anon_vma *anon_vma; struct list_head same_vma; // 所有鏈結到相同 anon_vma 的 avc struct list_head same_anon_vma; // 所有鏈結到相同 vma 的 avc};對應核心 commit/patch:
5beb49305251(mm: change anon_vma linking to fix multi-process server scalability issue)。
anon_vma_chain interval tree
把 same_anon_vma 鏈結串列換成 interval tree(以 augmented rbtree 實作),以每個 VMA 覆蓋的 [\text{vm_pgoff}, \text{vm_pgoff} + \text{vma_pages}) 區間為鍵。RMAP 走訪改為對目標 pgoff 做 stabbing query,只回傳區間真正覆蓋該 pgoff 的 VMA,複雜度 O(log n + 命中數)。同一個 merge window 中,file-back page 這一側行之有年的 prio_tree 也被同一套 interval tree 取代(6b2dbba8b6ac),anon 與 file 的反向走訪自此共用同一種索引結構,也就是今日 anon_vma_interval_tree_foreach() 與 vma_interval_tree_foreach() 巨集的由來。
struct anon_vma_chain { struct vm_area_struct *vma; struct anon_vma *anon_vma; struct list_head same_vma; /* locked by mmap_lock & page_table_lock */ struct rb_node rb; /* locked by anon_vma->rwsem */ unsigned long rb_subtree_last;#ifdef CONFIG_DEBUG_VM_RB unsigned long cached_vma_start, cached_vma_last;#endif};RMAP 走訪時,首先從 Page->mapping 獲取 anon_vma,接著從 anon_vma->rb_root 持續走訪 anon_vma_chain interval tree 檢查對應的 vma 的 vm_start 與 vm_end 判斷這個 vma 對應的 pte 是否 mapping 到這個 Page。
對應核心 commit:
bf181b9f9d8d(mm anon rmap: replace same_anon_vma linked list with an interval tree)
RMAP 與現有 Page reclaim 實作的關聯
當 Major Fault 處理中發現可用 Page 容量小於某種程度時會啟動 Page reclaim 機制,該機制在可用記憶體低於 WMARK_LOW 時觸發 kswapd 或直接由 page fault handler 在可用記憶體低於 WMARK_MIN 時進行 direct reclaim。回收時會根據 page 屬於的 LRU 層級,從 cold 資料優先選擇 victim 進行 reclaim。
不管是 direct reclaim 還是 kswapd 都會呼叫到 shrink_node()
# 背景回收kswapd -> balance_pgdat -> shrink_node -> shrink_lruvec -> shrink_folio_list -> {folio_referenced, try_to_unmap} -> __rmap_walk_file ...
# direct reclaim__alloc_pages -> __alloc_pages_slowpath -> try_to_free_pages -> shrink_node -> shrink_lruvec -> ...觀察 Active/Inactive List 如何使用 RMAP
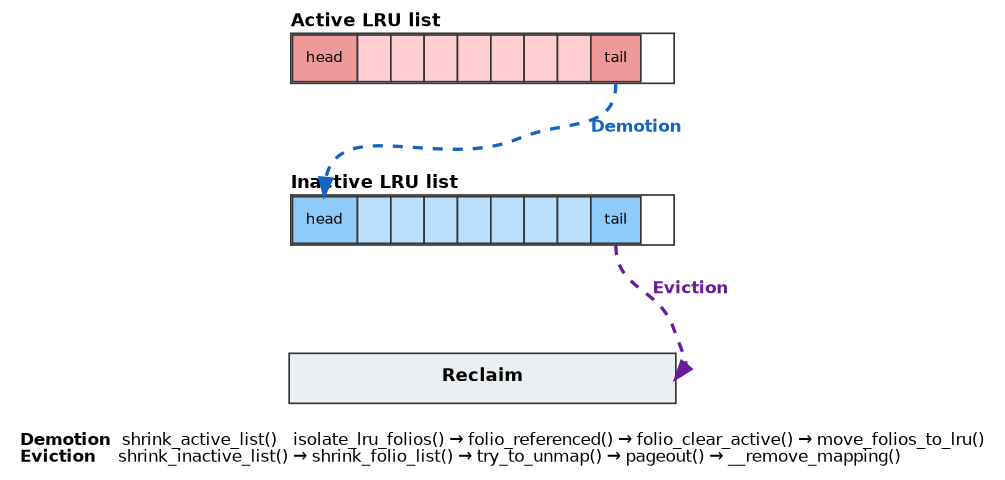
傳統 Active/Inactive list 的存取偵測完全建立在 RMAP 上。核心無法在硬體設定 Accessed bit 的當下得到通知,只能事後輪詢:folio_referenced() 對 folio 做一次 RMAP 走訪,逐一檢查並清除所有映射 PTE 的 Accessed bit,回傳「自上次檢查以來被幾個 VMA 存取」。
具體來說會有兩個路徑會進行 RMAP 走訪
- Demotion 時檢查 Active LRU list 的尾端 folio 有沒有被存取過,如果沒有就被移到 inactive list
- Eviction 時檢查 Inactive LRU list 的尾端 folio 有沒有被存取過,如果沒有就把這個 Folio 丟棄,否則重新移回 Inactive list
以 kswapd 為例,其呼叫 RMAP 的路徑為:
kswapd -> balance_pgdat -> shrink_node -> shrink_lruvec ├── shrink_active_list │ └── folio_referenced -> __rmap_walk_file │ ├── folio_referenced_one -> page_vma_mapped_walk │ └── vma_interval_tree_iter_first └── shrink_folio_list ├── folio_referenced -> __rmap_walk_file -> folio_referenced_one │ └── page_vma_mapped_walk └── try_to_unmap -> __rmap_walk_file -> try_to_unmap_one └── set_tlb_ubc_flush_pendingMGLRU 如何減少 RMAP 開銷
架構改進
首先,從架構層面來說,Active/Inactive List 在 eviction 的時候需要同時對 active 與 inactive LRU List 操作,而 MGLRU 由於其 Generation 自然老化的特性,因此在 eviction 時只須針對最老的 generation (min_seq) 操作。
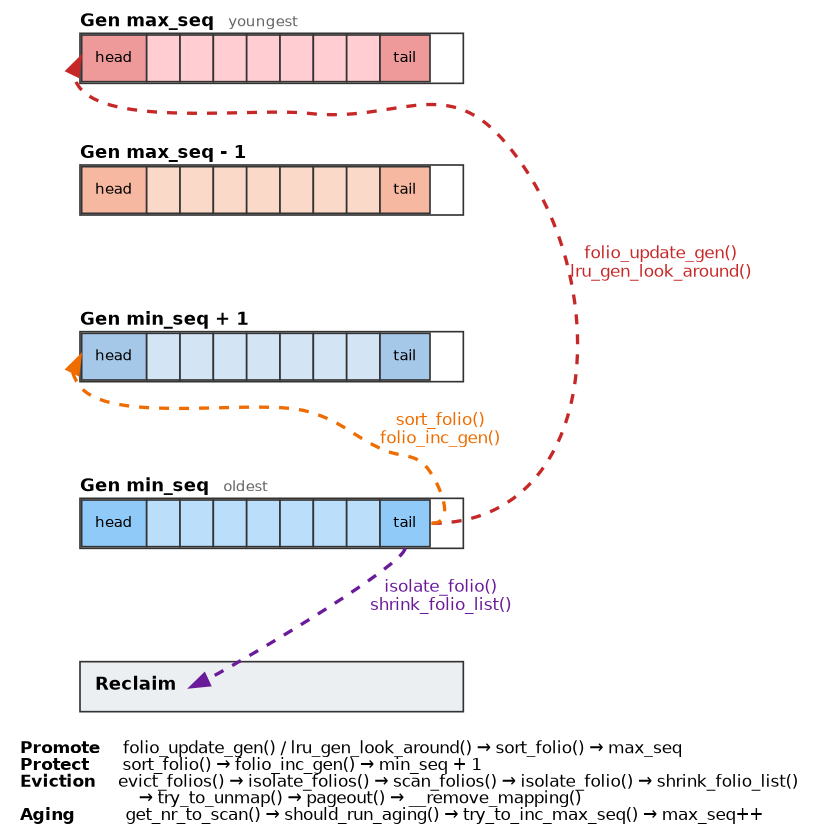
kswapd -> balance_pgdat -> kswapd_shrink_node -> shrink_node└── lru_gen_shrink_node └── shrink_one(global)/shrink_many -> shrink_one(memcg) └── try_to_shrink_lruvec -> evict_folios └── shrink_folio_list ├── folio_check_references -> folio_referenced │ └── rmap_walk -> rmap_walk_anon/rmap_walk_file │ └── folio_referenced_one │ └── page_vma_mapped_walk # 固定成本在這之前全數付清 │ └── lru_gen_look_around # 邊際成本近零的 64-PTE 視窗 │ ├── get_pte_pfn / get_pfn_folio │ ├── walk_update_folio # 鄰居就地升代 │ └── update_bloom_filter # 回饋給 aging └── try_to_unmap -> rmap_walk -> try_to_unmap_one接著來看 RMAP 走訪的成本結構。folio_referenced() 為了檢查一個 PTE 的 Accessed bit,固定要付:取得 vma object lock、interval tree 走訪、page_vma_mapped_walk() 逐層下降 Page table 定位 PTE、取得 page table lock(PTL)。而 LRU 依實體頁組織,串列上相鄰 folio 來自各 process 的不同 VMA。因此每次走訪都是一組毫無快取重用的鎖與樹操作。固定成本高、又完全不均攤,這就是為什麼 page_vma_mapped_walk 吃掉 kswapd 18.47% CPU。
patch1-6 39.03% lzo1x_1_do_compress (real work) 18.47% page_vma_mapped_walk (overhead) 6.74% _raw_spin_unlock_irq 3.97% do_raw_spin_lock 2.49% ptep_clear_flush 2.48% anon_vma_interval_tree_iter_first 1.92% folio_referenced_one 1.88% __zram_bvec_write 1.48% memmove 1.31% vma_interval_tree_iter_next
patch1-7 48.16% lzo1x_1_do_compress (real work) 8.20% page_vma_mapped_walk (overhead) 7.06% _raw_spin_unlock_irq 2.92% ptep_clear_flush 2.53% __zram_bvec_write 2.11% do_raw_spin_lock 2.02% memmove 1.93% lru_gen_look_around 1.56% free_unref_page_list 1.40% memset因此 lru_gen_look_around() 利用記憶體的空間局部性來改善頁面回收與熱頁面識別,當 shrink_folio_list 找到一個 Hot PTE (Accessed Bit = 1) 時以該 PTE 位址為中心劃出一個 PMD scan window,在其中搜尋總共 BITS_PER_LONG 個 PTE,檢查這些鄰近 PTE 的 Access bit 是否也為 1 (young) 並在足夠多 Hot page 時將 PMD 加入 Bloom filter 以在 Aging 時作為輔助判斷資訊。
最後是 Aging 部份,前面講到當 PMD 中包含足夠多 Hot page 時就會將 PMD 加入 Bloom filter,在 Aging 進行 Page Table 走訪時,會先對每個 PMD entry 查詢 Bloom Filter。如果該 PMD 存在於 Bloom filter,表示該 PMD 的 Hot page 密度足夠高,值得繼續走訪裡面的 PTE 並進行 Promote/Protect。
Reclaim 行為
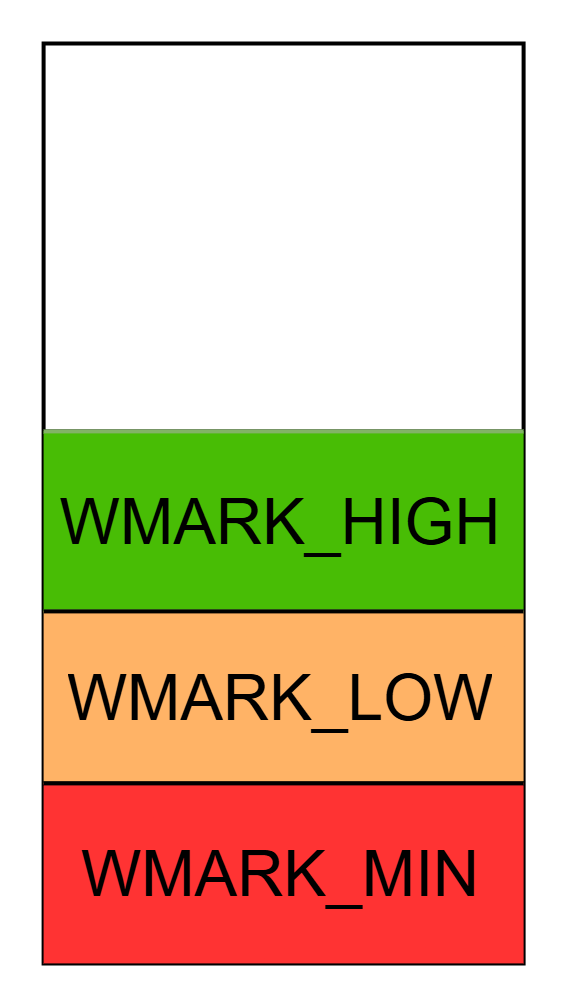
- cgroup memory.reclaim
- 主動式,手動觸發
echo <size> > /sys/fs/cgroup/<cg-name>/memory.reclaim
- direct reclaim
- 反應式,觸發於可用記憶體極度缺乏(水位低於 WMARK_MIN)
- 同步執行,Page fault 時檢查記憶體水位
- 水位提昇至 WMARK_LOW 後停止
- kswapd
- 可用記憶體水位低於 WMARK_LOW 觸發
- 背景執行,在 WMARK_HIGH 時停止
雲端公司如何自訂 Reclaim 策略
- Why? Kernel 的 Reclaim Policy 主要考慮 General case,雲端廠商發現在特定 Workload 導致 Regression,因此雲端廠商需要自己實作 Reclaim 的 Policy 來符合需求
Google:kstaled / Kreclaimd (ASPLOS 2019)
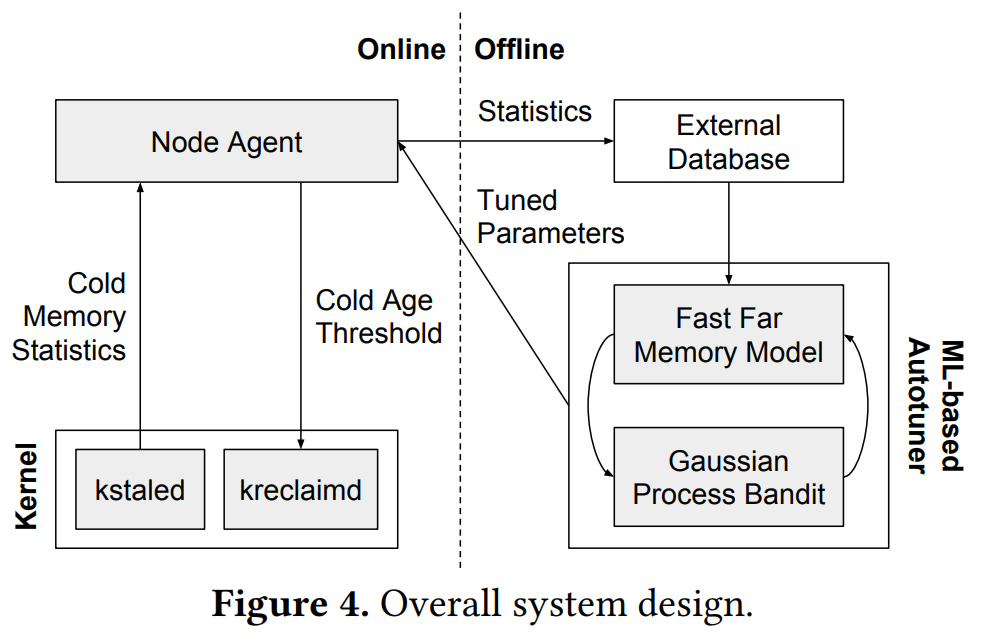
- kstaled:週期性走訪 Page table 讀取 Page 的 Accessed bit 以追蹤 Page age
- kreclaimd:將 Page age 超過門檻的 page swap out (壓縮到 Zswap)
- 架構發展:
- sysfs + bitmap
- kstaled / kreclaimd
- Overhead 隨記憶體大小與掃描頻率線性成長
- kstaled 掃描改為 PMD linked list 走訪 (降低 3.5 倍 CPU 使用)
- kreclaimd 改為接收 kstaled 資料
LSF MM 19
考慮這個 Reclaim 策略無法在 Userspace 處理,因此由 Shakeel Butt 主導,在 LSF MM 19 上提議將這個 Reclaim 策略推到 Upstream
- 社群發言與提問
- Rik van Riel:即使效能確實改善,仍存在 Scalability 問題
- 與會者:為什麼不直接用 kswapd?
It “kind of works”, he said, but is based on watermarks (keeping a certain percentage of memory free) rather than on idleness. kswapd also tries to balance memory usage across NUMA nodes, which is not useful in this setting. Finally, Butt said, kswapd is built on a large set of complicated heuristics, and he doesn’t want to try to change them.
- Johannes Weiner:為何重作 LRU List 在做的事,成本還高得離譜?
Google was willing to pay that cost, which was less than having the system go into direct reclaim.
社群共識:這類 proactive reclaim 確實對不少使用者有用,但這個特定解法的成本太高,不值得考慮合併進 upstream。
DAMON/S (Data Access MONitoring[-based operation Schemes])
- By SeongJae Park (sjp38),前 Amazon 員工
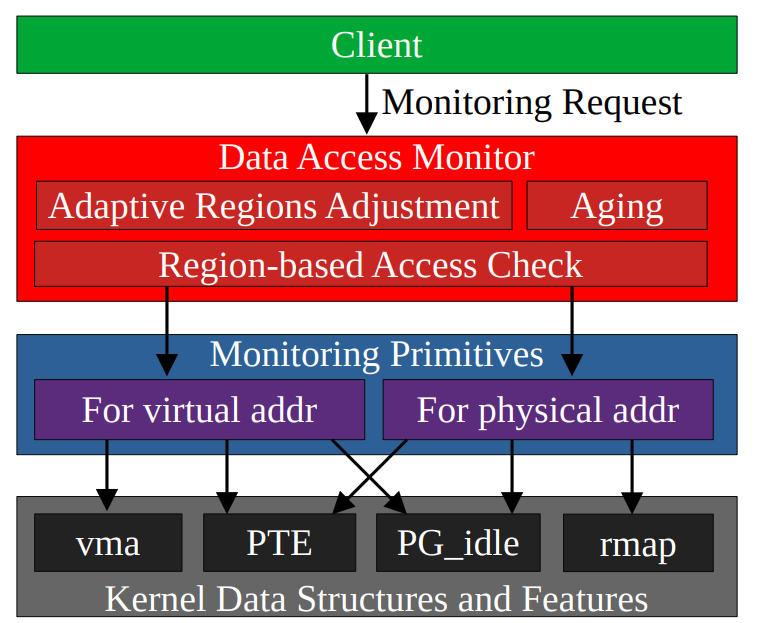
- Region-based sampling
- 將監測粒度從 Google 上面架構的 Page 改為 Region (可自訂 Region 大小)
- 使用抽樣法觀測 Region 熱度
- 每次取樣在每個 region 內隨機挑一個 Page,等一個 interval 後檢查它是否被存取,命中就把該 region 的 nr_accesses 加 1。
- Adaptive Regions Adjustment
- 前提是同一 region 內頁面熱度相近,而存取模式會變,所以 DAMON 依存取頻率自動合併與分裂 region,持續維持這個前提。
- 可基於觀測到資訊設計 reclaim 策略(DAMOS)
- Example: DAMON_RECLAIM
結論
- RMAP 架構改善圍繞於掃描 Page table 成本
- MGLRU 將 RMAP 走訪的整體 Overhead 分攤至各部分,並透過單次 RMAP 走訪成本換取較少 RMAP 走訪次數
分享文章
生成精美分享圖或複製連結,與更多人分享本文。
繼續閱讀
最後更新於 ,距今已過 65 天
部分內容可能已過時
評論